搜索相关性模型的输入越来越长:标题、属性、详情这些字段被拼在一起,一条 item 动辄上千个 token。同时,同一条 item 会在不同的 query 下被反复召回,与不同的 query 分别做一次相关性判断。于是我们有了一个想法——能不能把 item 预先压成一小段 KV 存起来,在线只让 query 对着这段 KV 做注意力,从而把 item 那上千个位置从在线计算里整个拿掉?
这个想法在论文里有个漂亮的形式,叫 gisting(Learning to Compress Prompts with Gist Tokens,Jesse Mu、Xiang Lisa Li、Noah Goodman,NeurIPS 2023)。论文的实验建在 LLaMA-7B 和 FLAN-T5-XXL 上,语料是 Alpaca+,其中 prompt 普遍不长:训练集平均 20 个 token,人工评测集平均 26 个;摘要里那个 26 倍压缩比,就是拿人工评测集算出来的。这个尺度和我们手里的长 item 相差很远,结论不能直接照搬。此篇想弄清楚的事情只有一件:把这套做法搬到搜索、推荐里去,哪些环节成立,哪些环节会出问题。
论文做了什么
gisting 的做法很直接。把 prompt 和 $k$ 个 gist token 拼在一起前向一遍,取出这些 gist 位置每一层的 key 和 value,存下来。这一坨张量就是论文说的 $G$。
为什么留下来的非得是 KV?因为 Transformer 里一个 token 算完之后,对外输出的只有 K 和 V 两组张量,hidden state 并不会传给后面的 token。后面的 token 在注意力里能读到的,只有前面那些 token 的 K 和 V。所以想让 prompt 的信息留给后面读它的 token,能传下去的只有这一份 K/V,别无他法。
训练只需要改掩码:gist 之后的 token 不能看 gist 之前的 token,形状上就是普通因果掩码挖掉左下角那一块。论文附录 A 给了完整的 PyTorch 实现,真正要动的只有十来行。这样一来,prompt 看不见后面的输入,后面的 token 也只能通过那 $k$ 个位置看见 prompt;这个瓶颈由结构强制产生,不靠 loss 项施压。损失照常算,梯度只能穿过 gist 回流到对 prompt 的编码上。想预测得准,模型就得把 prompt 里真正有用的东西压进那 $k$ 个位置。
两种形态:
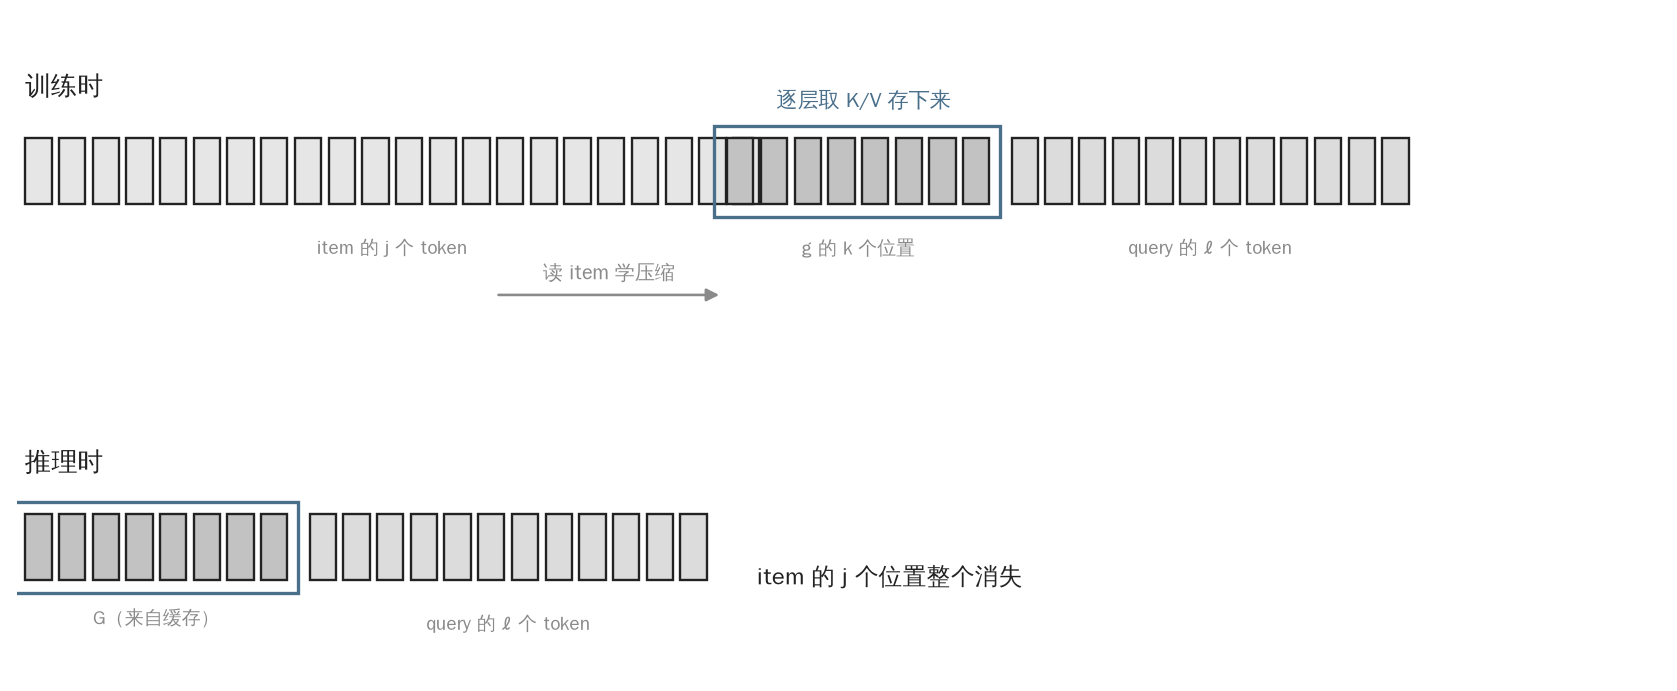
训练时 prompt 必须在场,gist 靠读它才学得会压缩;推理时 prompt 的位置整个消失,gist 已经在缓存里。这个不对称是整套方案的核心,也是最容易在实现里搞混的地方。若把推理的写法顺手搬到训练,等于教模型压缩空气。
先看复用结构
把 gist 搬到相关性任务上,我们第一个要确认的问题是压哪一侧。两侧其实都在复用:一条 query 配 $N$ 条候选,压一次能用 $N$ 次;同一条 item 又会在 $M$ 条 query 下被召回,被反复计算。区别在复用的量级。
先看不压缩的情形:每条候选要过 $j + \ell$ 个 token 的层,其中 $j$ 是 item 的长度,$\ell$ 是 query 的长度。只压 item,每条候选只剩 $\ell$ 个 token;只压 query,每条候选仍要过 $j$ 个。由于 $j$ 通常在一千上下而 $\ell$ 只有几十,后者的在线开销几乎等于不压。放到总量上看更清楚:item 侧的节省是 $M \times j$,query 侧是 $N \times \ell$,而 $M$ 与 $N$ 差着几个数量级、$j$ 与 $\ell$ 又差一个数量级。
所以这一侧该压 item。这个判断和论文正好相反——论文压的是 prompt,因为 prompt 被反复引用;而在我们这里,被反复计算的是 item。
顺带说一句,直接缓存 item 原始前缀这条路走不通。每个位置的 KV 有 $2 \times L \times H \times h$ 个数,其中 $L$ 是层数、$H$ 是 KV 头数、$h$ 是每个头的维度;以 24 层、2 个 KV 头、head_dim 64 为例,一个位置 12 KiB,一条 1000 token 的 item 光前缀就要 12 MiB,10 万条就是 1.2 TB。缓存还没换成吞吐,显存先没了。压到 $k$ 个位置之后,同一条 item 是 96 KiB,128 倍的差距——这才让缓存这件事有讨论的余地。
在线的一次 attention
在线时序列里没有 item,也没有 gist 占位符。token 层面只有 query,gist 是以 KV 的形式在注意力里出现的。
1 | # 在线:每个 (item, query) 一次 |
此处有两件事值得说。第一,第 $i$ 层的 $G$ 依赖 item 跑完前 $i-1$ 层的隐状态,所以离线必须把 item 完整跑一遍全层,逐层把 gist 位置的 K/V 都存下来,存储量是 $2 \times L \times k \times H \times h$ 个元素每一条,而不是一个向量。
第二,位置编码。训练时 gist 落在 $j+1$ 到 $j+k$ 这一段,query 排在 $j+k+1$ 之后;推理时我们把 query 从 $k+1$ 起编号,两边 query 到 gist 的相对距离都是 $k$。RoPE 只依赖差值,整体平移不影响点积,所以这个编号方式在数学上是等价的。但若框架按序列长度自动生成 position_ids,你把 $j$ 个 token 删掉之后 query 就从 1 起编,相对距离就错了,注意力跟着全错,而且不会报错,只是指标莫名掉一截。这是这类实现里最难查的一类 bug。
论文对这一点全篇没有交代,只在第六节顺口提了一句绝对位置编码会限制窗口,没有任何实验。这一段没有现成答案,只能自己试。
除了位置编码,还有一个更容易踩的坑。既然 item 的位置在推理时被掩码挡住,会有人想:干脆把它们填零、留在序列里,反正不参与计算。这个等价性有一个很硬的前提,就是 gist 的 KV 必须真的来自缓存。若框架没有 prefix cache 的注入路径,「填零」就变成让 gist 对着一堆零做注意力,压出一个空表示,输出完全错。更要命的是它一点开销都省不下来:填零的 token 仍然占着位置,仍然要做 QKV 投影、仍然要逐层跑 FFN。我们要省的是把 item 从序列里拿掉,而不是留着它占位。
收益有多大:算力
这一项最容易被高估,所以我们自己算一遍。
我们不妨把每层每 token 的浮点运算数写出来。线性部分大致是:QKV 投影(GQA 4:1)$1.5D^2$,输出投影 $D^2$,MLP $8D^2$,合计 $10.5D^2$,其中 $D$ 是隐层宽度。注意力部分要对 $S$ 个可见 key 打分再加权,是 $2SD$。二者相除,$D$ 约掉一项:
$$\frac{2SD}{10.5D^2} = \frac{S}{5.25D}$$
代入 $D = 896$、$S = 72$($k = 8$、$\ell = 64$),得到 1.5%。也就是说,序列长度只通过 $2SD$ 这一项进来,而它在总量里始终是个零头。
换成论文附录 F 的说法更清楚:每层注意力里只有三个算子依赖 KV 长度(KQ logits、softmax、softmax 乘 V);单个新 token 的 QKV 投影和整个 FFN,与 KV 长度无关。
比例走势:
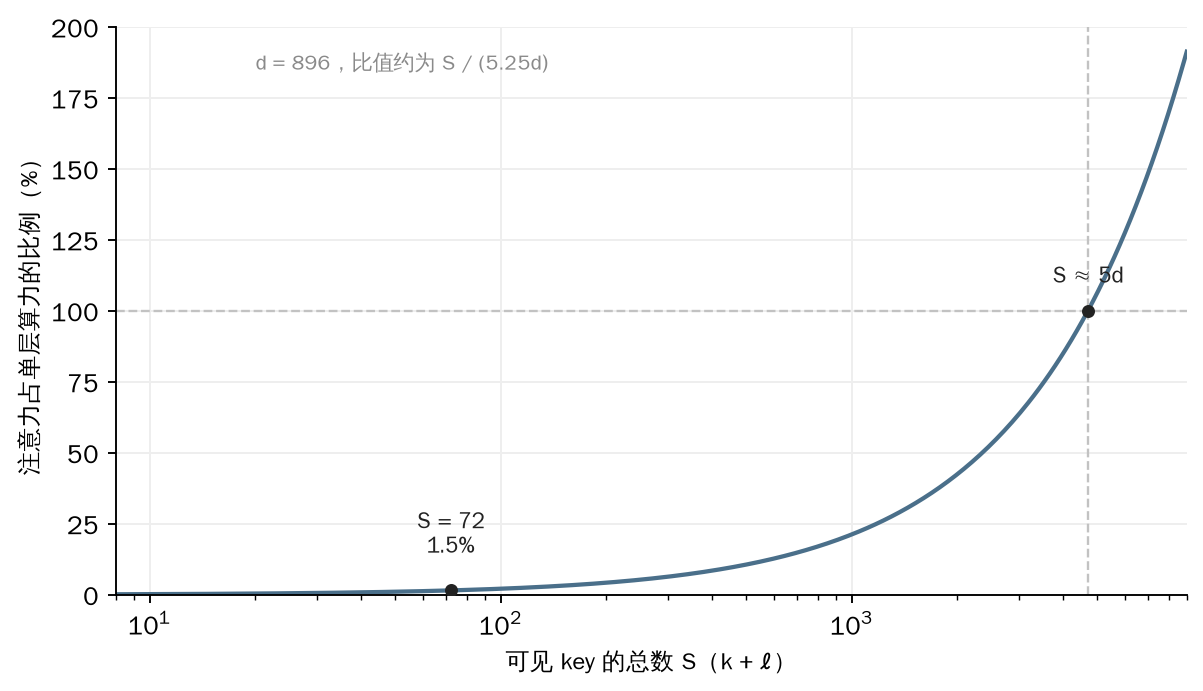
注意力要到 $S \approx 5D$ 才能与线性部分打平,$D = 896$ 时是 4700 个 token 左右,短序列下它永远追不上。这顺便解释了长上下文之所以贵的原因:$S$ 一涨,它就无上限地涨,而线性部分纹丝不动。
那么,省下来的这点算力到底值多少?拿这个结论回头读论文摘要,我们会读出一点别的味道。摘要说 40% 的 FLOPs 下降,那是对着完全不缓存算的。把对手换成指令 KV 缓存,同样是一行配置,收益是 0.11%,墙钟 1.0%。26 压到 1 的理论上限就是 0.12%,实测 0.11%,一分不多。
墙钟降 1.0%,比 FLOPs 的 0.11% 高出一个数量级,原因是这个规模下瓶颈在 HBM 搬运——那 1% 里真正省下来的不是算力,是 KV 读取。
顺着这条线,另一半也要补上。decode 是带宽瓶颈,不是算力瓶颈:一步里每个候选摊到的权重是 810 KB(24 层 × 16.9 MB,批 500),KV 是 192 KiB,约占五分之一;批到两千左右两者持平。所以「砍 $k$ 不省算力」这句话只对 FLOPs 成立,在线延迟恰恰由 KV 读取这条流量决定。
顺带说一句,如果目标只是「在同样的机器上跑更大的模型」,gist 这个量级撑不起来。真正的数量级杠杆在别处:MoE 稀疏、KV 量化(KV quantization),以及投机解码(speculative decoding)这类手段,随便一个都是成倍的收益。gist 的独特性在于它不需要改架构。模型冻结、结构动不得的生产环境,改改掩码就能拿到一部分收益,这是别的手段给不了的。
收益有多大:存储
我们先把公式写出来:每个位置的 KV 占 $2 \times L \times H \times h \times b$ 个字节,其中 $b$ 是每个元素的字节数。麻烦在于同一档位的模型,KV 头部配置相差很远。同样取 $k = 8$、10 万条 item、fp16:
- 24 层、2 个 KV 头、head_dim 64:每位置 12 KiB,总量 9.2 GiB
- 32 层、5 个 KV 头、head_dim 64:每位置 40 KiB,总量 30 GiB
- 28 层、8 个 KV 头、head_dim 128:每位置 112 KiB,总量 85 GiB
你会看到,配置不同,总量可以差到九倍。所以「一张 80G 卡能装 10 万条」这种话没有意义;你自己的模型到底能装多少条,得把参数代进去算——第三格那一档,一张 80G 卡连 10 万条都装不下。
GQA 在这里是双刃。它让 $G$ 按 KV 头数存,本身就省;可每层每个 gist 位置只提供 $H$ 组 V,要供 $H_q$ 个 query 头共用。64 个 query 头配 8 个 KV 头,通道就窄了八倍。存储省下来了,用来承载细节的容量同时变窄。论文只用了 MHA 的 LLaMA-7B,没碰过这个维度。
装不下的时候自然要分片
但分片要连计算一起切,不能只切缓存。
因为一次打分里,query 侧要传的只是 token id,$\ell = 64$ 也就二百多字节,item 侧则是 96 KiB,差两个数量级。所以该让 query 去 item 那边算;反过来把 $G$ 拉到 query 这边算,一次请求就要传几十 MB。
一条请求 50 条候选,按 item id 哈希到 $M$ 片,每片分到 $50/M$ 条,算完回传几个分数。这里有两层扩容:分片扩容量,复制扩吞吐,总机器数是两者之积。缓存是可从 item 内容重算出来的,不是有状态数据,所以分片不必为可用性做副本。某片挂了,那部分 item 退回现场重算,慢一些但不影响正确性。
按第一格的配置算,1000 万条 item 是 916 GiB,一张 80G 卡留 70 GiB 给缓存,$M \approx 14$;换成第三格,$M \approx 122$。同一份需求,八倍的机器差——全在 KV 头数上。你手上那张卡能装多少条,就看这几个数。
能不能再进一步
item 压完,我们很自然会问 query 能不能也压。形状是:query 也压成 $k'$ 个 gist 位置,在线只剩 EOS 一个 token,对 $k + k'$ 个 key 做注意力。
算力上的收益很可观。$\ell = 64$、$N = 50$ 时,token-层单位从 $50 \times 64$ 降到 $64 + 50 \times 1$,二十几倍。而且算 query gist 的一次性成本大致等于今天一条候选的成本(都是 $\ell$ 个 token 过 $L$ 层),所以 $N \ge 2$ 就抵得过来。论文那边给出的复用门槛也是 $R = 2$,两边是同一个道理。
而这个代价落在另一处。query gist 是在见到 item 之前就定死的。交叉编码器的核心能力,恰恰是 query 能按 item 重新解读:同一句「大号红色卫衣」,对着不同候选,该被激活的是不同的词。只压 item 时这个能力还在,$\ell$ 个 query token 各对着 $G$ 做一次注意力,等于对 item 有 $\ell$ 个视角,最后在 EOS 汇合。query 也压掉之后,只剩一个视角。
在线路径:
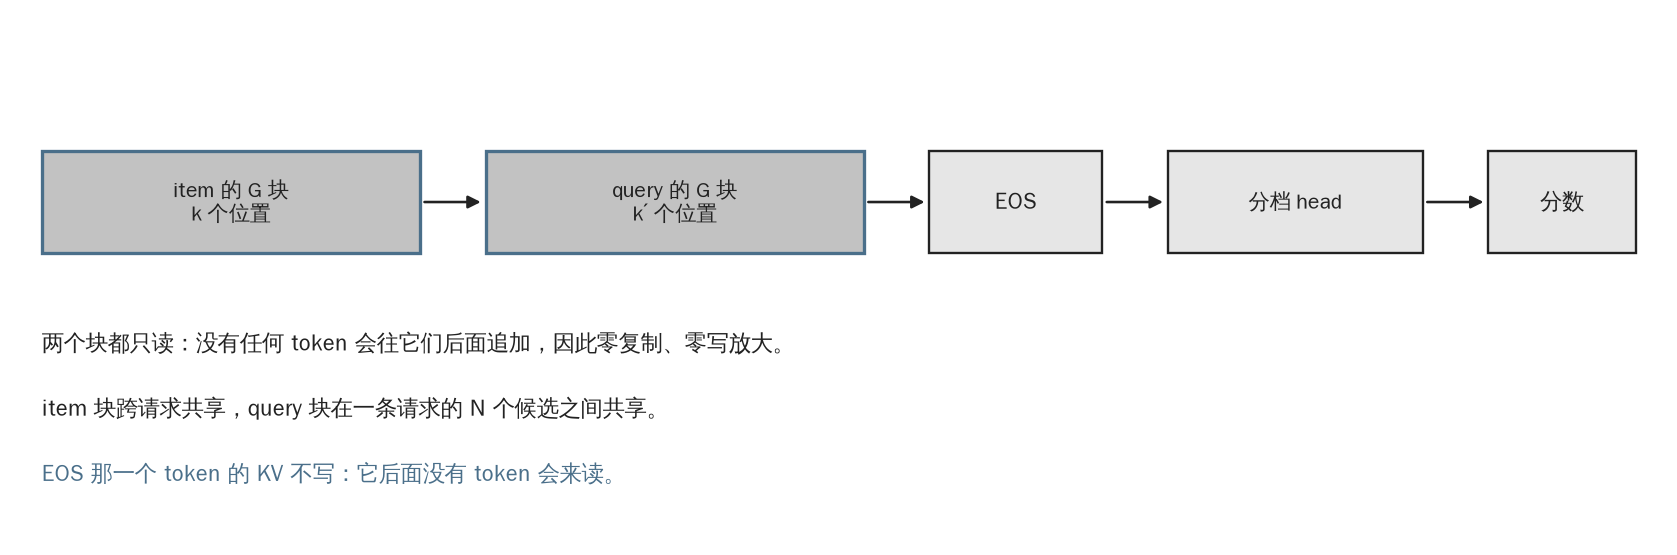
两个块都是只读的,没有任何 token 会往它们后面追加,所以零复制、零写放大。EOS 那一个 token 的 KV 根本不用写,因为后面没有 token 会来读它。整条路径退化成一次无状态的前向:读两个只读块,算一个 token,出分。
麻烦在于不能用 hash-based prefix cache。item 的 $G$ 没有对应的 token 前缀,它是离线算出来的,跟任何输入序列都不对应,必须走显式的 KV 注入,或者自己写一层 attention 把预计算块拼进去。这属于实打实的开发量,不是开个开关就有。另外把 $k + k'$ 对齐到块大小(vLLM 是 16)是免费的优化,$8 + 8$ 正好一块;不对齐就是四分之一的浪费。
真正的风险在任务性质
前面都是工程侧的事。真正决定这套东西能不能落地的,是效果,而且是一处错配。
论文的成功模式是「意思对、格式错」。它举的例子是:prompt 要求从 News & Buzz、Travel、Style、Arts & Culture、Politics 里选一个分类,正控答 Arts & Culture,gist 答 Culture。语义没错,枚举值错了。人工评测集上逐字一致率只有约 10%,而模型还能拿到 45.8% 的胜率,它就是靠着意思对活下来的。
相关性判定不吃这一套。它是判别任务,判的恰恰是逐字级字段是否匹配:型号、容量、年份。「iPhone 15 Pro 256GB」和「128GB」的差别,正是被压掉的那一类信息。论文的强项是语义近似,我们的需求是字段精确,两者正交,调参解决不了。
论文那句「$k$ 不敏感,$k = 10$ 反而更差」也不能直接搬。它成立的前提是信息余量极大:二十来个 token 的 prompt 大概几百 bit,塞进 26 万个浮点数,$k = 1$ 已经富余得离谱。我们这里是 $j \approx 1000$ 压到 $k$,压缩比高一个数量级,这个前提直接不成立。论文自己把「压缩很长的 prompt、大 $k$ 的少样本」列进了未来方向,明说没做。
还有一个反向的警告。论文里 TF-IDF 那组对照在 FLAN-T5 的人工评测集上拿了 $-5.9$,比完全不压还差。压得不够解释不了这个数;它压错了方向,留下一个显眼但无关的关键词,反而误导。gist 若压掉的是规格字段、留下的是营销词,结局一样。
顺便把评估口径钉死。级联里最危险的是承接率掉:item 压过之后某些候选被打低,进不了下一阶段,后面的模型再好也救不回来。所以我们该量的是它对全量排序 oracle 的 recall@K——拿不压 query 时的全量排序当参考答案,看这一档的 top-K 捞回了多少。这个数掉得多,说明这一档不该待在这个位置,得把 $k$ 加大或者干脆退回全量。
所以我们起步的做法应该保守:先只压 item,把 $k$ 从 4 扫到 16,评估按 $j$ 的分位切开看。长 item 承担了几乎全部损失,只看全局平均会把它们稀释掉。
query 留原样,保住的正是字段级对齐这个能力。两边都压的算力收益更漂亮,但它关掉的东西,恰好是相关性判定最需要的那样东西。