设想这样一个搜索相关性模型:用一个 0.5B 量级的小模型,把 item 和 query 拼成一条序列送进去,取最后一个 EOS 位置的隐状态,接一个 MLP 做相关性分档。item 侧拼着标题、属性、详情,动辄上千个 token;query 侧只有几十个。同一条 item 会在许多不同的 query 下被召回,每一次都要连同 query 从头算一遍。于是我们自然会想,能不能把 item 预先压成一小段 KV 存下来,在线只让 query 对着这段 KV 做注意力,把 item 那上千个位置从在线计算里拿掉。
这个想法与 gisting 很接近(Learning to Compress Prompts with Gist Tokens,Jesse Mu、Xiang Lisa Li、Noah Goodman,NeurIPS 2023)。此篇前半讲这篇论文做了什么,后半讨论把它搬到相关性任务上以后,哪些地方成立,哪些地方要改,哪些地方搬不过去。
要解决的问题
同一个 prompt 被反复使用时,每次都要重新编码一遍。这样做的代价有三点。
第一,prompt 本身占着上下文窗口,把真正要处理的内容挤了出去。
第二,注意力的计算量随输入长度平方增长,而同一个 prompt 一天可能被编码几百万次。论文举的例子是 ChatGPT 的系统 prompt。
第三,把 prompt 的 KV 缓存下来可以省掉重算,但缓存本身要占显存和存储,缓存的 prompt 越多,资源就越紧张。
针对这个问题,过去有三种尝试。
第一种是全量微调,给每个任务训一个专用模型。prompt 已经融进权重,推理时不必再带上它。但每个任务都要重训一遍,还要单独收集这个任务的输入输出数据。
第二种是参数高效微调,例如 prefix-tuning 或者 adapter。它只学一小块参数,不必全量重训。但每个任务仍然要存一份参数,也仍然要那个任务的训练数据。
第三种是上下文蒸馏,让不带 prompt 的学生模型去模仿带 prompt 的老师模型。训练数据可以由老师自己采样,不需要外部数据。但每个任务仍然要训一份学生模型。
这三种做法的共性问题在于,成本随任务数线性增长。论文用的 Alpaca+ 有十三万条样本,其中不同的任务就有十万四千多个,prompt 的分布是长尾的,不可能逐个任务去训练、去存储。
gisting 换了一个学习对象。它学一个函数 $G$,输入任意 prompt $t$,输出它的压缩表示 $G(t)$。新任务来了不必训练,前向算一次就能用,训练时没见过的 prompt 也是如此。
具体做法
先说 $G(t)$ 是什么。把 prompt 和 $k$ 个 gist token 拼在一起前向一遍,取出这 $k$ 个位置在每一层的 key 和 value,合起来就是 $G(t)$。
之所以要存 K/V,是因为在 Transformer 的每一层里,后面的 token 只能通过注意力读到前面 token 的 key 和 value,前面 token 的隐状态并不会直接交给后面的 token。想让 prompt 的信息留给后面的 token 读,能存下来的就是这一份逐层的 K/V。
拿 prefix-tuning 对照会更清楚。两者的形状一样,都是挂在序列前面的若干组逐层 K/V;区别在来源。prefix-tuning 的 prefix 是每个任务用梯度下降学出来的参数,gisting 的 prefix 是语言模型拿 prompt 当输入现场算出来的。论文说 $G(t)$「约等于参数」,指的就是它占据的正是 prefix 参数所在的那些位置。
训练上的改动有这样几处:
- 词表:加一个 gist token。
- embedding 矩阵:加一行,对应这个新 token。
- 输入:依次拼接 prompt、$k$ 个 gist token、输入 $x$ 和目标 $y$。这 $k$ 个 gist token 用的是同一个 token id,只是位置不同,经过第一层之后激活就不一样了。
- 注意力掩码:gist 之后的 token 不能看 gist 之前的 token。形状上,这就是在普通因果掩码里挖掉左下角那一块。论文说改动大约十行代码,附录 A 给了 PyTorch 实现。
改完之后,$x$ 和 $y$ 都看不到 prompt,能从 prompt 读到信息的只剩那 $k$ 个 gist 位置。损失照常只算 $y$ 的部分,梯度要回到 prompt 的编码上,只能穿过这 $k$ 个位置。模型想把 $y$ 预测准,就必须把 prompt 里有用的内容压进这几个位置。这个约束完全来自掩码,损失函数里没有为它额外加任何一项。
用 encoder-decoder 模型时要改三处。第一,encoder 里 $x$ 不能看 prompt。第二,encoder 里 prompt 和 gist 不能看 $x$。第三,decoder 的 cross-attention 不能看 prompt。第二条最容易漏,而它恰恰是缓存能够成立的前提:如果 prompt 的编码依赖了 $x$,它的表示就随输入而变,没法预先算好存下来。
论文说 gisting「没有额外的训练成本」,准确的意思是不加模块、不改损失函数、不换训练数据、也不加训练阶段,和普通的指令微调是同一个训练循环。序列确实长了 $k$ 个 token,这部分开销很小。
效果评估
先交代数据。Alpaca+ 由 Self-Instruct 和 Stanford Alpaca 合并而成,共 130,321 条样本,覆盖 104,664 种不同的任务。约 59% 的任务没有输入,例如「写一首关于青蛙的诗」。训练集里的 prompt 平均约 20 个 token。
验证集有三个,难度依次递增。Seen 是一千条见过的任务配上没见过的输入;Unseen 是一千条没见过的任务;Human 是 252 条人工手写的任务,prompt 平均约 26 个 token,比训练集更长,属于分布外。摘要里的 26 倍压缩比,就是拿 Human 集的平均长度除以 1 个 gist token 算出来的。
结果要对着四组对照来读:
- 正控:1 个 gist token,但不改掩码,等于普通的指令微调,是性能上限。
- 负控:完全不给 prompt,相当于 gist 里什么也没压进去,是下限。
- gist:被检验的对象。
- TF-IDF:把 prompt 换成其中最有代表性的一个关键词,让压缩率和单个 gist token 相当。
TF-IDF 这一组最关键。它把压缩率固定住,剩下的差异就只来自「压成连续激活」还是「压成离散的词」。没有这一组,就分不清掉分是因为压得太狠,还是因为压的方式不对。
下面的数字是 ChatGPT 评判的胜率,归一化到正控为 100、负控为 0:
- LLaMA-7B:Seen 92.4,Unseen 98.8,Human 84.9
- FLAN-T5-XXL:Seen 103.9,Unseen 84.4,Human 63.2
- TF-IDF(LLaMA-7B):Seen 16.2,Unseen 15.9,Human 8.6
有五个地方需要留意。
第一,分布内几乎无损,掉分主要发生在分布外。
第二,encoder-decoder 掉得更多,FLAN-T5 在 Human 集上只剩 63.2。论文的解释是 gist 掩码打断了 encoder 里的双向注意力,模型比较难适应;作者也说这个假设还需要验证。
第三,TF-IDF 在 FLAN-T5 的 Human 集上是 $-5.9$,比完全不给 prompt 还差。我的推测是,留下的那一个关键词把模型引向了错误的方向;论文没有对这个数字做解释。
第四,逐字一致率远低于胜率。gist 模型的输出和正控完全相同的比例,Seen 上接近 50%,Unseen 上 20% 到 25%,Human 上只有约 10%;而在 Human 集上,LLaMA-7B 对正控的胜率仍有 45.8%。也就是说,答案的意思基本对,字面常不同。
第五,gist token 数量 $k$ 不敏感。论文试了 1、2、5、10,曲线基本平,LLaMA-7B 在 $k = 10$ 时反而变差。作者猜测是容量变大以后对训练分布过拟合了,所以全文都用 $k = 1$。
效率数字要先交代参照系。论文的表 3 测的是单次前向,只输入 1 个新 token,在 Human 集的 252 条 prompt 上取平均。拿完全不缓存作对照,LLaMA-7B 的 FLOPs 降了 40%,墙钟时间降了 6.8%。把对照换成「prompt 的 KV 已经缓存好」,FLOPs 只降 0.11%,墙钟时间降 1.0%。论文给的原因是,单个新 token 的前向里,算力主要花在这个 token 自己的投影和 MLP 上,对 KV 缓存做注意力只占很小一部分。附录 F 按带 KV 缓存长度的公式重算了一遍,26 个位置压到 1 个,理论上的改善是 0.12%,和实测的 0.11% 吻合。所以 gisting 相对 prompt 缓存的收益主要在存储:LLaMA-7B 每个位置的 KV 是 1.05 MB(fp32),26 个位置压成 1 个,同样的存储就能多缓存 26 倍的 prompt。
失败模式有两种。第一种是需要逐字复制的细节被模糊掉了。论文的例子要求从 News & Buzz、Travel、Style、Arts & Culture、Politics、Tech、Science & Health 七个分类里选一个,正控答 Arts & Culture,gist 模型答 Culture:语义没错,枚举值错了。第二种是失控重复。让模型给一个 LaTeX 目录的例子,gist 模型输出了几百个 token 的 \subsubsection{The Basics} 和 \paragraph{The Basics}。作者说不清为什么只有 gist 模型会这样。
作者承认的局限是,压缩必然丢掉 prompt 的部分细节,落地前要自己评估算力和精度之间的权衡。
此外,论文还有三件事没有做。第一,推理时 $x$ 的位置怎么编号,正文没有讨论。第二,没有和「每个任务学一个 prefix」这条真正对应的基线直接比较,而「零样本地算出 prefix」正是这套方法的卖点。第三,论文说更长的序列和更大的 batch 会带来更多加速,但没有给出数据。
压缩对象的选择
回到相关性任务。我们第一个要定的是压哪一侧。
初看之下,一条请求里的 $N$ 条候选共享同一个 query,压 query 似乎更自然。但 query 只有几十个 token,压掉它以后,每条候选在线仍然要过 item 的 $j$ 个 token,在线开销几乎没有变化。item 则不同:它长,热门 item 又会在大量请求里反复出现,每出现一次就要重新编码一次。所以要压的是 item。放到论文的框架里看,item 占据的位置就是论文里 prompt 的位置。
此外 $k$ 和 gist token 的设置先固定下来,不按 item 热度分档。这样一次排序里所有候选走的都是同一条计算路径,分数之间可以直接比较。
两种形态:
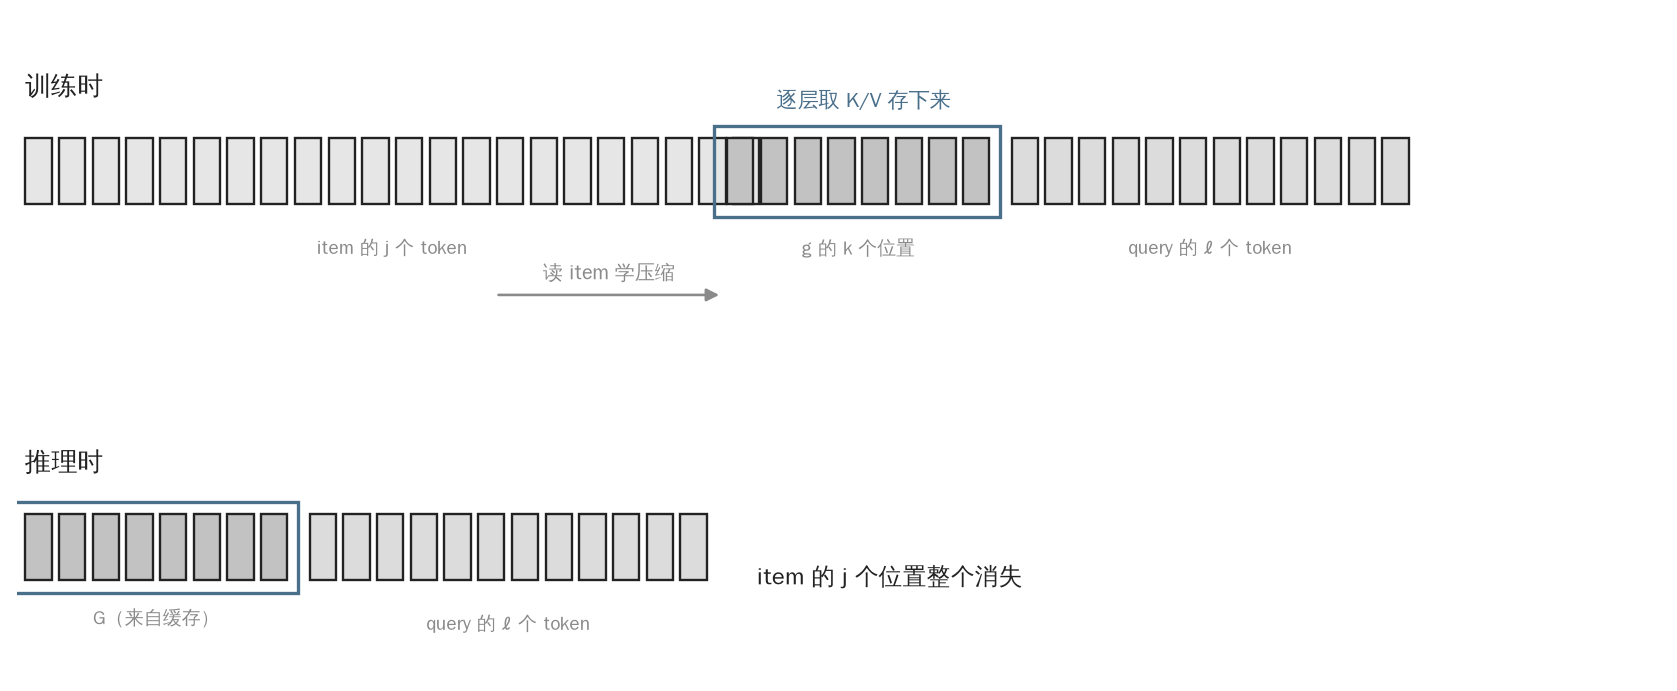
训练时 item 必须真实在场,gist 是靠读真实的 item 学会压缩的;推理时 item 的 $j$ 个位置整个消失,gist 以缓存 K/V 的形式出现在每一层的注意力里。训练和推理的这一处不对称,是实现时最容易混淆的地方。
收益的来源
论文和我们的场景,前缀在整条序列里的占比正好相反。论文里 prompt 平均 26 个 token,只占序列的一小部分;我们这里 item 有上千个 token,query 只挂在后面。这一处差别决定了收益落在哪里。下面取 $j = 1024$、$\ell = 64$、$k = 8$,分两种对照来看。
先对照今天的做法,也就是每次都把整条序列送进交叉编码器重算。用了 gist 缓存以后,每条候选在线要过的 token 从 $j + \ell$ 个降到 $\ell$ 个,单看线性部分就少了十七倍左右。
再对照「缓存 item 的原始前缀」。这种做法在线同样只算 query,和 gist 的差别只剩注意力里可见 key 的数量:一边是 $j + \ell$ 个,一边是 $k + \ell$ 个。我们不妨把每层每个 token 的运算量粗略写出来。线性部分(GQA 4:1 的 QKV 投影、输出投影、MLP)合计约 $10.5D^2$,注意力部分是 $2SD$,其中 $D$ 是隐层宽度,$S$ 是可见 key 的个数。两者之比为
$$\frac{2SD}{10.5D^2} = \frac{S}{5.25D}$$
$D = 896$、$S = 72$ 时,这个比例是 1.5%;$S = 1088$ 时约是 23%。所以相对于原始前缀缓存,gist 在线每个 token 只少算两成左右。
比例走势:
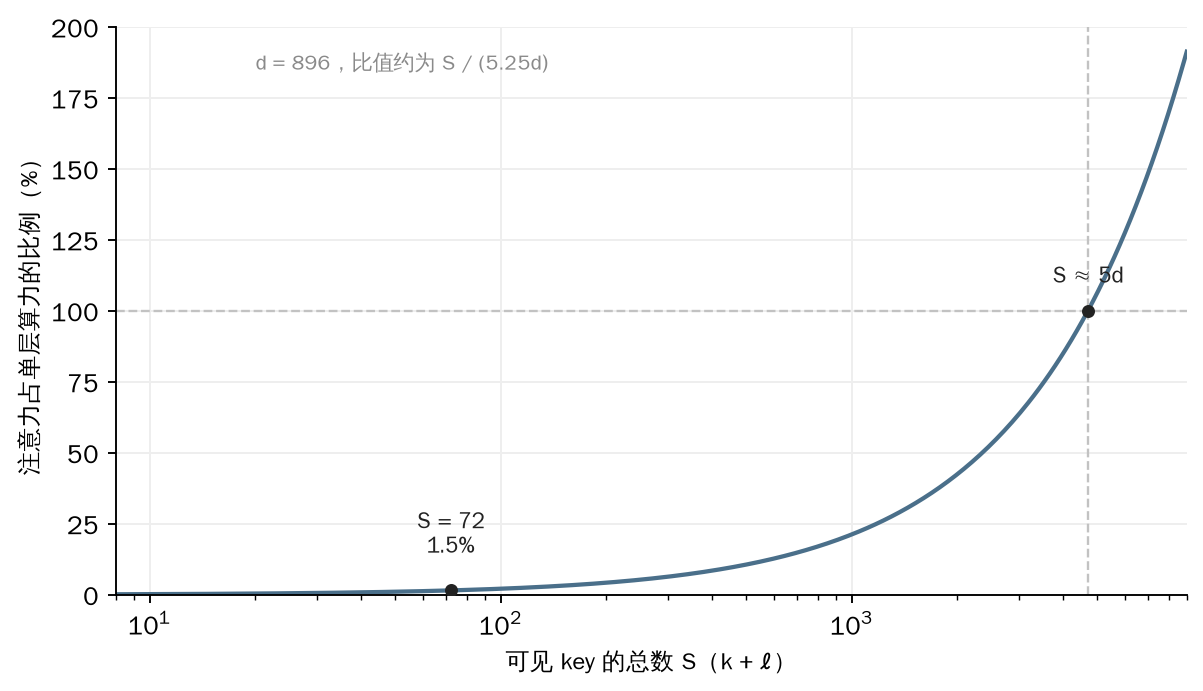
两种对照放在一起,我们就能看清楚:省算力的是「缓存 item」这件事本身,gist 的作用是让缓存存得下。论文对照的是已经缓存好的 prompt,prompt 本身又短,所以只量到 0.11%。我们今天的实际做法是不缓存,所以能拿到缓存本身带来的那部分算力。
存储这一侧,每个位置的 KV 是 $2 \times L \times H \times h \times b$ 个字节,其中 $L$ 是层数,$H$ 是 KV 头数,$h$ 是 head_dim,$b$ 是每个元素的字节数。以 24 层、2 个 KV 头、head_dim 64、fp16 为例,每个位置是 12 KiB,一条 1024 个 token 的 item,原始前缀就要 12 MiB,十万条超过 1 TiB;压到 8 个位置以后是 96 KiB,相差 128 倍。
这个倍数由 $j / k$ 决定,总量则取决于模型配置。同一档位的模型,KV 头数相差很远。同样取 $k = 8$、十万条 item、fp16:
- 24 层、2 个 KV 头、head_dim 64:每个位置 12 KiB,总量 9.2 GiB
- 32 层、5 个 KV 头、head_dim 64:每个位置 40 KiB,总量 30 GiB
- 28 层、8 个 KV 头、head_dim 128:每个位置 112 KiB,总量 85 GiB
三档之间相差九倍左右,差别全部来自层数、KV 头数和 head_dim。第三档的配置下,一张 80G 的卡装不下十万条。
这组数字还有另一面。LLaMA-7B 的一个 gist 位置每层有 32 个头、每个头 128 维,32 层合计 262,144 个数;上面第一档配置的一个 gist 位置只有 6,144 个数,是前者的四十分之一左右。GQA 又让多个 query 头共用同一组 K/V。也就是说,在我们的小模型上,每个 gist 位置能承载的信息比论文里少得多。论文只在 MHA 的 LLaMA-7B 和 FLAN-T5 上做了实验,这一处需要自己补实验。
分片
单卡装不下时就要分片,而且要连计算一起切。一次打分里,query 一侧要传的只是 token id,64 个 token 也就几百字节;item 一侧的 $G$ 在第一档配置下是 96 KiB。所以应当让 query 去 item 所在的分片上算。反过来把 50 条候选的 $G$ 拉到 query 这边来算,第一档配置下一次就要传 4.7 MiB,第三档要传 44 MiB。
按 item id 哈希到 $M$ 个分片,一条请求带 50 条候选,每个分片分到 $50 / M$ 条,算完只回传分数。分片数决定能装多少条 item,副本数决定吞吐,机器总数是两者之积。$G$ 可以从 item 内容重新算出来,不是必须持久化的状态,所以分片不必为了可用性做副本;某个分片挂掉,那部分 item 退回现场重算,慢一些,但分数不变。
按第一档配置,一千万条 item 是 916 GiB,每张 80G 的卡留 70 GiB 给缓存,$M$ 约为 14;第三档要 122 片左右。
位置编码
位置编码是最容易写错、写错了又不报错的地方。训练时 item 占据第 1 到第 $j$ 个位置,gist 占据第 $j+1$ 到第 $j+k$ 个位置,query 从第 $j+k+1$ 个位置开始。缓存下来的 gist 的 K,已经按第 $j+1$ 到第 $j+k$ 个位置做过 RoPE 旋转。
RoPE 只依赖相对位置,所以推理时 query 的位置必须仍然从 $j+k+1$ 开始编号,和训练时保持同样的相对距离。若框架按序列长度自动生成 position_ids,删掉 item 以后 query 会从 1 开始编号,它到 gist 的相对距离就变成了负数,注意力全错,程序也不会报错,只是指标莫名其妙地掉下去。
由于每条 item 的 $j$ 不同,最简单的做法是把 $j$ 和 $G$ 一起存下来,在线给每条候选单独传 position_ids。另一种做法是在训练时就把 gist 固定在同一段位置上:把 item 右对齐,编号到某个固定的 $P$ 为止,gist 永远落在 $P+1$ 到 $P+k$。这样所有候选里 query 的起始位置都相同,batch 起来更方便。
上线
固定 $k$ 之后,同一对 item 和 query,走缓存算出的分数和现场重算的分数理应完全一致。这样,缓存在 A/B 实验里就是不可见的。上线就是一次常规的相关性模型版本切换:新版本在请求级灰度,和以往的模型升级用同一套流程。缓存只是新版本内部的实现,可以随线上流量逐步填满。
有两件事要提前做好。第一,缓存的 key 里要带上模型版本和 item 内容的 hash。否则模型一换,就会拿旧权重算出的 K/V 喂给新权重,分数悄悄偏掉。第二,切流之前,在离线环境里对同一批 item 和 query 同时跑缓存路径和全量重算路径,比对分数。差值应当在浮点误差以内;位置编号错了、缓存 key 撞了、K/V 来自旧版本,这几类问题都会在这一步暴露出来。
把 query 也压掉
item 压完以后,我们会接着问 query 能不能也压。形态是 query 也压成 $k'$ 个 gist 位置,在线每条候选只剩 EOS 一个 token,对 $k + k'$ 个 key 做注意力。
按「token 数 × 层数」估算,一条请求 50 条候选、$\ell = 64$ 时,在线计算从 $50 \times 64$ 降到 $64 + 50 \times 1$,少了二十多倍。query 的 gist 每条请求算一次,代价大致等于今天一条候选的代价,候选数不少于 2 时就抵得过来。
在线路径:
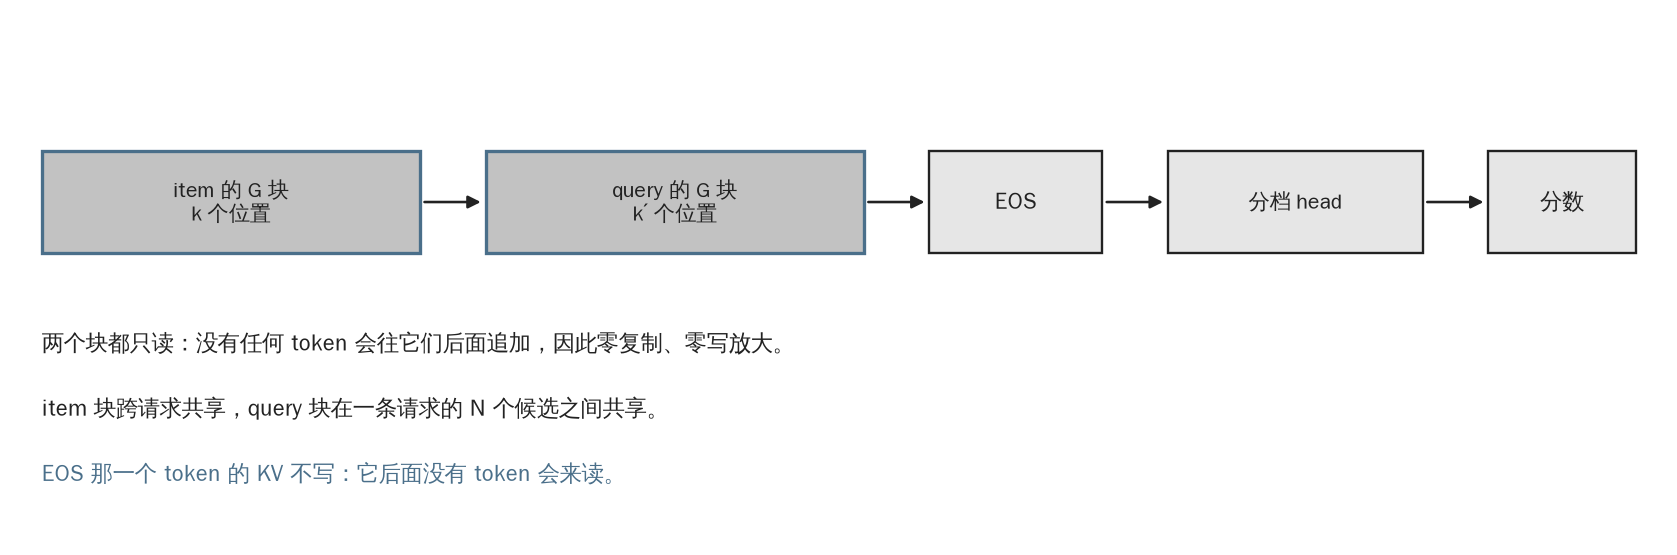
代价在于,query 的 gist 是在见到 item 之前就定下来的。交叉编码器的长处恰恰是 query 能按 item 重新解读:同一句「大号红色卫衣」,对着不同的候选,起作用的是不同的词。只压 item 时,这个能力还在,$\ell$ 个 query token 各自对着 $G$ 做注意力,相当于从 $\ell$ 个角度读 item;query 也压掉以后,只剩 EOS 这一个角度。
工程上还有一处要说明。vLLM 这类框架的 prefix cache 是按 token 前缀的 hash 命中的,而 item 的 $G$ 是离线算出来的,不对应任何 token 前缀,所以不能直接用 prefix cache,要显式地把 K/V 注入注意力,这是实打实的开发量。
由此得到的分工是:精排用半压,只压 item,query 保持原样;粗排对精度要求低、候选多,可以用全压,或者用 $k$ 更小的半压。
搬不过去的地方
前面讨论的都是工程问题,都有办法解决。真正搬不过去的地方在任务性质上。
论文是生成任务,靠「意思对」就能拿分。Human 集上逐字一致率只有约 10%,胜率仍有 45.8%,Arts & Culture 压成 Culture 也只算小错。相关性判定是判别任务,判的恰恰是字段是否逐字匹配:型号、容量、年份。「iPhone 15 Pro 256GB」和「128GB」的差别,正是 gist 最容易压掉的那一类信息。论文验证过的能力和我们需要的能力在这一点上是冲突的。
论文里「$k$ 不敏感」的结论也不能直接搬。论文压的是二十来个 token 的 prompt,交给的又是一个 MHA 的 7B 模型,单个 gist 位置的容量远远够用。我们要把上千个 token 压进 $k$ 个位置,而每个位置的容量只有它的四十分之一左右。论文自己把「压缩很长的 prompt」列进了未来工作,明确说没有做。
评估口径也随之变化。精排一侧,参考答案是 item 和 query 都不压的全量交叉编码器,除了看相关性指标,还要按 item 长度 $j$ 的分位分别看:几乎全部损失都集中在长 item 上,只看全局平均会把它们稀释掉。粗排一侧,最危险的是承接率下降:一条本该排进前列的候选在粗排被压低,进不了精排,后面的模型再好也救不回来。所以要看粗排 top-K 对参考排序 top-K 的召回率。
起步时,先只压 item、query 保持原样,$k$ 取 4、8、16 三档,按 $j$ 的分位切开评估。